Resposta rápida: a inteligência artificial funciona aprendendo padrões a partir de exemplos. Durante o treinamento, um modelo matemático (geralmente uma rede neural) analisa milhões de dados e ajusta seus parâmetros internos para errar cada vez menos. Depois de treinado, ele usa esses padrões para fazer previsões ou gerar conteúdo novo — como um assistente de conversa que prevê, palavra por palavra, qual é a continuação mais provável de um texto.
Este artigo faz parte da série “IA em 3 níveis”, que responde às perguntas mais buscadas sobre inteligência artificial no Google por brasileiros (segundo dados do Google Trends divulgados pelo TecMundo). Cada resposta vem em três versões: para crianças, para adultos iniciantes e para especialistas.
Neste artigo
- Explicando para crianças
- Explicando para adultos que estão começando
- Explicando para especialistas em tecnologia
- Perguntas relacionadas
- Fontes e leituras recomendadas
Como funciona a inteligência artificial? Explicando para crianças
Pense em um jogo de adivinhação. No começo, o computador chuta qualquer coisa. Quando erra, alguém diz “não, tente de novo”. Quando acerta, ele guarda o que funcionou. Depois de jogar milhões de vezes, ele fica muito bom em adivinhar!
Por dentro, a IA tem algo parecido com uma grande rede de botões de volume. Cada botão aumenta ou diminui um pouquinho a importância de uma pista — como “tem bigode?” ou “tem orelha pontuda?”. Aprender, para a IA, é ir girando esses botões até as respostas ficarem certas.
Quando você conversa com um robô de bate-papo, ele está brincando de “completar a frase”: olha o que você escreveu e escolhe a palavra que mais combina para vir depois, uma de cada vez. É por isso que às vezes ele parece muito esperto — e às vezes inventa coisas que não são verdade.
Como funciona a inteligência artificial? Explicando para adultos que estão começando
A maior parte das IAs atuais usa aprendizado de máquina (machine learning). O processo tem três etapas principais:
- Dados: reúne-se uma grande quantidade de exemplos — textos, fotos, áudios, registros de compras. A qualidade desses dados define boa parte da qualidade (e dos vieses) da IA.
- Treinamento: o modelo faz previsões, compara com a resposta certa e corrige seus parâmetros internos para reduzir o erro. Isso se repete bilhões de vezes, em computadores muito potentes.
- Uso (inferência): já treinado, o modelo recebe uma entrada nova — sua pergunta, por exemplo — e produz uma resposta em segundos.
As redes neurais são o tipo de modelo mais usado hoje. Elas são inspiradas, de forma bem livre, nos neurônios do cérebro: camadas de “unidades” que recebem números, fazem contas e passam o resultado adiante. Quanto mais camadas, mais padrões complexos a rede consegue captar — daí o nome aprendizado profundo (deep learning).
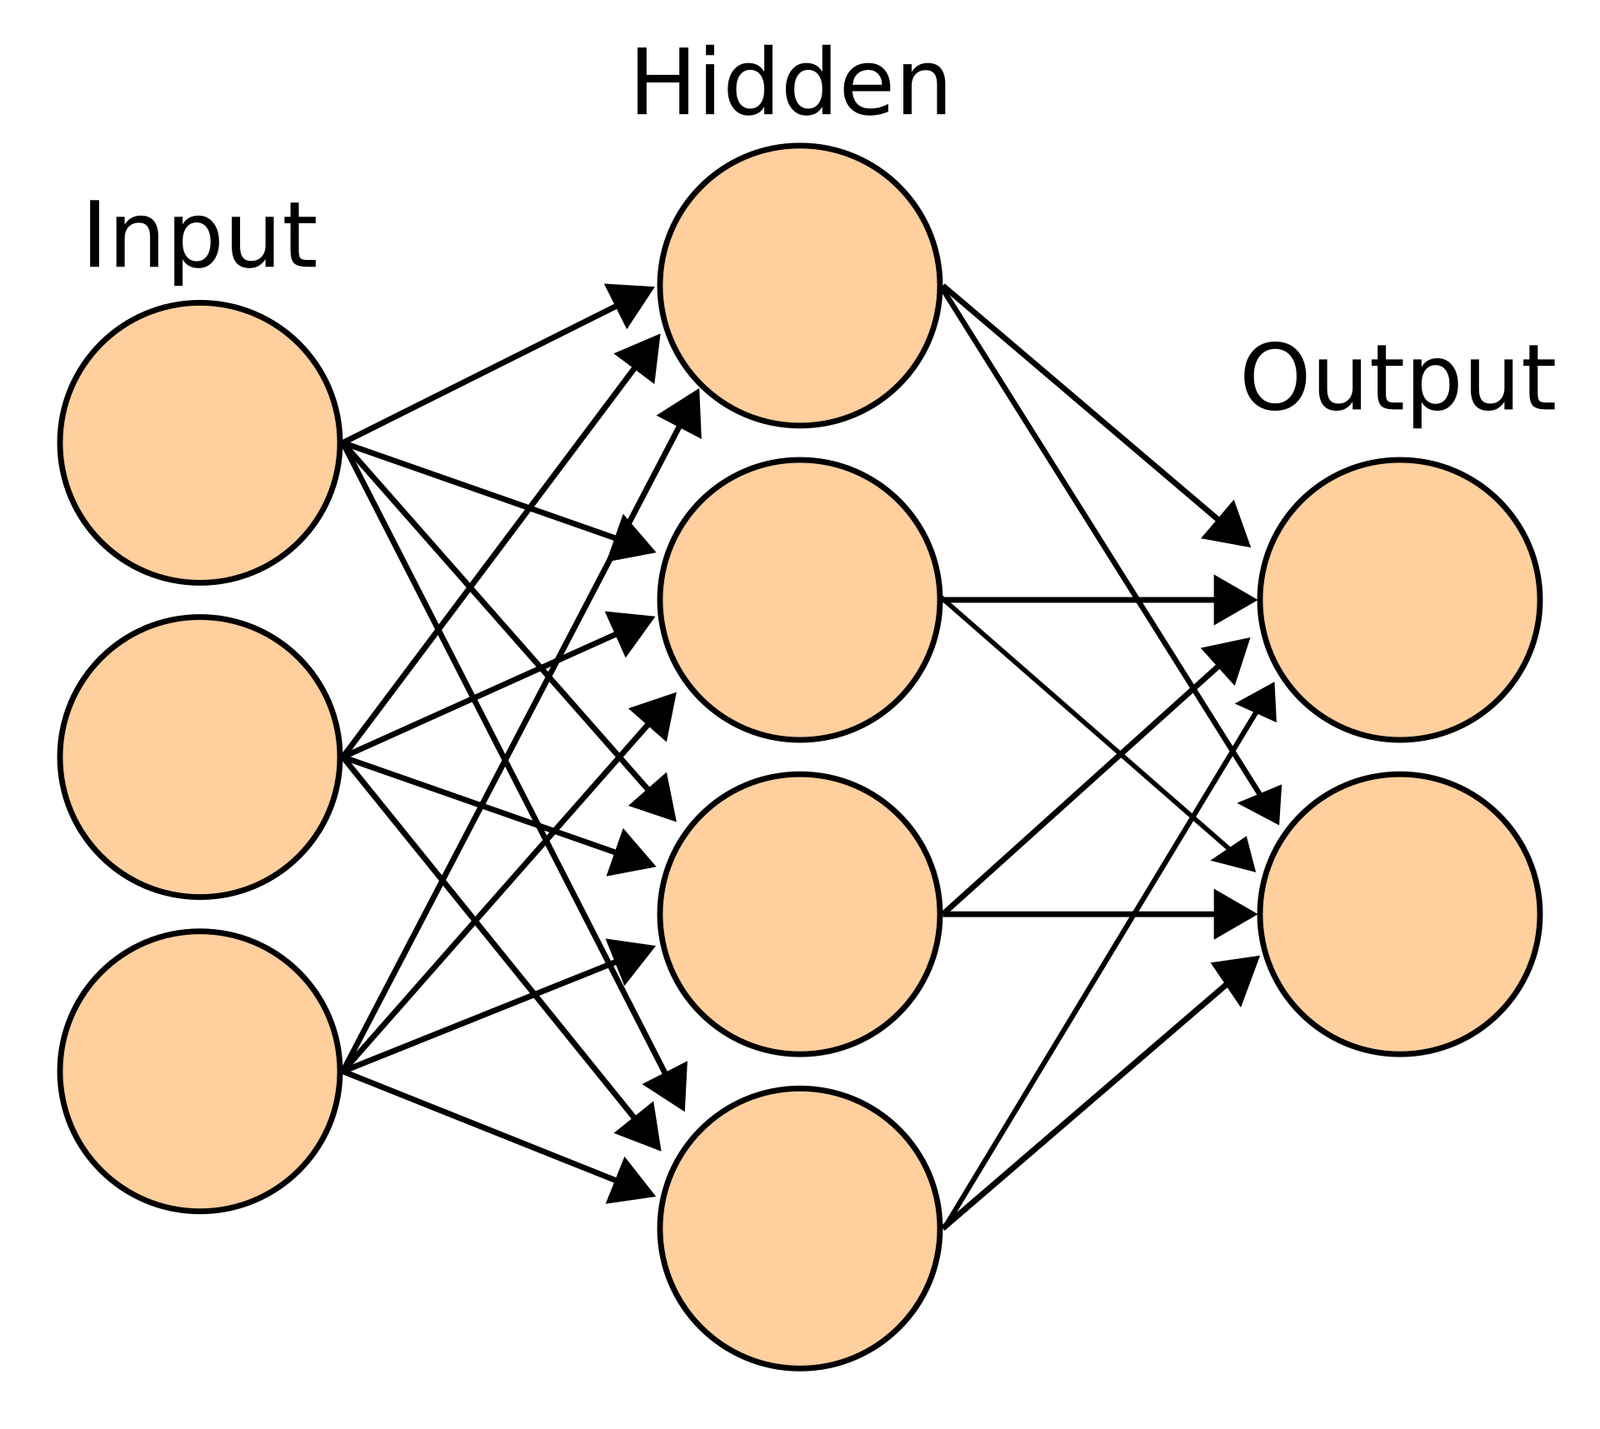
Os assistentes de conversa, como ChatGPT, Gemini e Claude, são grandes modelos de linguagem (LLMs). Eles foram treinados com enormes volumes de texto para prever a próxima palavra (ou pedaço de palavra) de uma frase. Depois, passam por uma etapa de ajuste com avaliações humanas para responder de forma mais útil e segura. Importante: eles não consultam uma enciclopédia por padrão — geram respostas prováveis, o que explica os erros. Para aproveitar melhor, veja como usar a inteligência artificial no dia a dia.
Quer ir além? O livro Deep Learning, de Ian Goodfellow, Yoshua Bengio e Aaron Courville (MIT Press, 2016), é a referência clássica sobre redes neurais e está disponível gratuitamente on-line. Para uma visão mais acessível, Artificial Intelligence: A Guide for Thinking Humans, de Melanie Mitchell, explica esses mecanismos sem matemática.
Como funciona a inteligência artificial? Explicando para especialistas em tecnologia
No núcleo do paradigma atual está a minimização de uma função de perda por gradiente descendente estocástico, com gradientes calculados via backpropagation sobre redes neurais profundas (LeCun, Bengio e Hinton, 2015). O salto recente veio da arquitetura Transformer (Vaswani et al., 2017), que substituiu recorrência por autoatenção: cada token computa pesos de relevância sobre todos os demais (softmax(QKᵀ/√d)·V), permitindo paralelização massiva no treino e captura de dependências de longo alcance.
O pipeline típico de um LLM moderno:
- Pré-treinamento autorregressivo (previsão do próximo token) em corpora de trilhões de tokens; o desempenho segue leis de escala aproximadamente previsíveis em função de parâmetros, dados e compute (Kaplan et al., 2020);
- Ajuste por instruções (SFT) e alinhamento por preferências — RLHF (Ouyang et al., 2022) e variantes como DPO e abordagens baseadas em princípios;
- Inferência com decodificação amostral (temperatura, top-p), cache de chaves/valores e, cada vez mais, cadeias de raciocínio estendidas com mais compute em tempo de teste;
- Ampliação por ferramentas e contexto: RAG (Lewis et al., 2020) para ancorar respostas em fontes externas, chamadas de função e arquiteturas agênticas.
Pontos de atenção para quem projeta sistemas: alucinações são consequência estrutural de um objetivo de verossimilhança, não um bug pontual — mitigam-se com grounding, verificação e calibração; avaliações em benchmarks estáticos sofrem com contaminação de dados; e riscos de segurança como prompt injection crescem com a autonomia dos agentes. O NIST AI RMF e seu perfil para IA generativa (NIST AI 600-1) são boas referências para estruturar testes e controles.
Sobre os fundamentos: o algoritmo de backpropagation foi popularizado por Rumelhart, Hinton e Williams em artigo na Nature (1986); a capacidade de LLMs realizarem tarefas a partir de poucos exemplos no próprio prompt (in-context learning) foi demonstrada com o GPT-3 (Brown et al., 2020). Do lado crítico, Bender et al. (2021) cunharam a metáfora dos “papagaios estocásticos” para alertar que fluência linguística não implica compreensão, e a revisão de Ji et al. (2023), publicada na ACM Computing Surveys, sistematiza tipos, causas e métodos de mitigação de alucinações.
Perguntas relacionadas
Continue a série “IA em 3 níveis”:
- O que é inteligência artificial?
- Como usar a inteligência artificial no dia a dia?
- Como surgiu a inteligência artificial e quem criou?
- Como saber se um texto foi escrito por IA?
Fontes e leituras recomendadas
- Vaswani et al. — Attention Is All You Need (2017)
- LeCun, Bengio & Hinton — Deep learning (Nature, 2015)
- Kaplan et al. — Scaling Laws for Neural Language Models (2020)
- Ouyang et al. — Training language models to follow instructions with human feedback (2022)
- Lewis et al. — Retrieval-Augmented Generation (2020)
- NIST — AI Risk Management Framework
- IBM — What is artificial intelligence (AI)?
Livros e artigos acadêmicos
- GOODFELLOW, Ian; BENGIO, Yoshua; COURVILLE, Aaron. Deep Learning. Cambridge, MA: MIT Press, 2016. Versão on-line gratuita
- RUSSELL, Stuart; NORVIG, Peter. Inteligência artificial: uma abordagem moderna. 4. ed. Rio de Janeiro: GEN LTC, 2022. (Original: Artificial Intelligence: A Modern Approach, Pearson, 2020.) Site do livro
- RUMELHART, David E.; HINTON, Geoffrey E.; WILLIAMS, Ronald J. Learning representations by back-propagating errors. Nature, v. 323, p. 533–536, 1986. DOI: 10.1038/323533a0
- LECUN, Yann; BENGIO, Yoshua; HINTON, Geoffrey. Deep learning. Nature, v. 521, p. 436–444, 2015. DOI: 10.1038/nature14539
- VASWANI, Ashish et al. Attention Is All You Need. NeurIPS, 2017. arXiv:1706.03762
- BROWN, Tom B. et al. Language Models are Few-Shot Learners. NeurIPS, 2020. arXiv:2005.14165
- BENDER, Emily M. et al. On the Dangers of Stochastic Parrots: Can Language Models Be Too Big? FAccT ’21, ACM, 2021. DOI: 10.1145/3442188.3445922
- JI, Ziwei et al. Survey of Hallucination in Natural Language Generation. ACM Computing Surveys, v. 55, n. 12, 2023. arXiv:2202.03629
Imagem de destaque: Wikimedia Commons (CC0 – domínio público). Diagrama de rede neural: Cburnett (CC BY-SA 3.0).